RubyWorld Conference 2023に参加!!
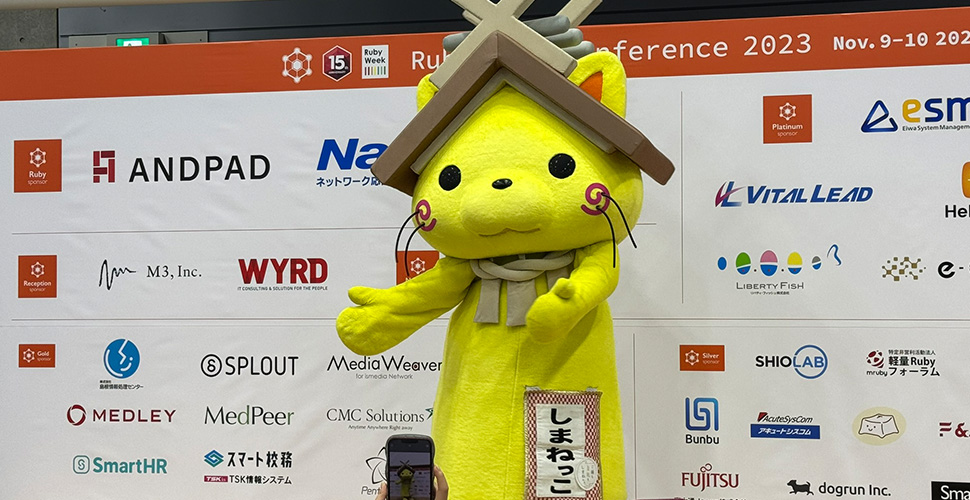
初めまして! 今年の6月に入社した冨田です。 入社して、早くも4ヶ月が経ちました。初めてブログを書く機会が来ました! 最初のテーマは、「RubyWorld Conference 2023に参加!!」です。Rubyが生まれて30年、RubyWorld Conferenceが始まって15年という節目を迎えた今年、参加することができて良かったです。 初日の冒頭では、「歴史から学ぶ」というテーマでRubyの生みの親である”まつもとゆきひろ”さん(以下、Matzと呼ばせていただきます)の基調講演から始まりました。 今までのRubyの歴史・将来のRuby・OSSコミュニティについてなどをわかりやすくお話していただきました。 特に印象的だった部分は、 We are f**ed unless we can come up with something that will excite the community, because everyone’s getting bored and going off and doing other things 「コミュニティを刺激するなにかがないと、興味を持つ人が減って、他の分野に流れてしまう」のような意味合いがあると思いますが、技術が日進月歩で発展していく中で、どのように刺激的なことを起こしていくのかという部分がとても興味深かったです。 Rubyが生まれて30年という節目で、Hype CycleのPlateau of Productivityに突入しています。これは、技術が広く受け入れられて安定期に入った段階を指します。 Matzは、技術の成熟が進み、安定期に入った段階が停滞期になっていないかと危惧していました。Rubyが更なる発展を遂げていくためには、より魅力的な言語・コミュニティになっていく必要があります。 現在、Rubyをメインに勉強している私としては、Rubyの発展のために積極的に参加し、貢献していけるよう努力していきたいなと感じました。 また、別会場では多くの企業が出展しており、各企業ブースも見学させていただきました! 特に印象に残ったブースは、Smalrubyとmruby/cを使ったMatz葉がにロボコンを共催する「しまねOSS協議会」でした。 松江工業高等専門学校の主催で、第1回 Matz葉がにロボコンが開催されるようで、ブースで宣伝を行っていました。興味のある方は紹介ムービーをぜひご覧ください。 動画の紹介でもあるように、白線に沿って動いていくようにプログラミングしていくのですが、多足歩行ロボットなので、揺れによってセンサが動いてしまい、なかなか思い通りに進まないという絶妙な難しさが良いみたいです。 メインは、小学生をターゲットとしていますが、中学生以上のオープン部門があるそうなので、一度挑戦してみたいなと思いました! その時は、スクラッチではなく素のRubyを使ってプログラミングしてみたいと思います! 以上で、初めてのブログ記事を締めたいと思います。ありがとうございました〜 写真は、本物の松葉がにです(Matz葉がにではありません)
WordPressで構築したブログをAstroに移行してみた
こんにちは。 18年ぶりに阪神タイガースがアレしたので、嬉しくてたまらない小林です。 最近、同僚にAstroというWebフレームワークを教えてもらってからというもの、面白くて仕方なく、毎週何かしら触って遊んでいます。 弊社のブログでは、Astroに関して初めて触れるのですが、それが何かというは割愛します。 Astroって何?という方は、以下を参照してください。 はじめに チュートリアル ある程度、Astroを理解している人向けの内容になります。 はじめに 今回のテーマは、 WordPressで運用されているブログをAstroに移行する です。 以下のようなことを検討している場合に有益なのではないかと考えています。 WordPressでの運用をやめたい 記事のレビューをGitHubのPullRequestで行いたい そもそも、WordPressとAstroを組み合わせるという話になると主に2つの方法があります。 WordPressに組み込まれたREST APIを使用する 一つ目は、ビルド時にWordPressにアクセスして、取得したデータを元にブログ用のページを生成する方法です。 参考:Headless WordPress & Astro WordPressのデータをMarkdown変換して使用する 二つ目は、WordPressのデータをMarkdownに変換し、チュートリアル内にもあったようにプロジェクトの一部として管理する方法です。 参考:Migrating from WordPress 今回は、目的が「WordPressをやめたい」なので、後者を選択します。 応答に時間が掛かる、サーバーの負荷を減らしたいみたいな場合は前者を選択した方がよいと思います。 ブログをWordPressからAstroに移行する WordPressから記事のデータをXMLとして出力する まず、WordPressの投稿したデータをXMLファイルに出力します。 WordPressのダッシュボード > サイドバー > ツール > エクスポート を選択します。 「エクスポートする内容を選択」からエクスポートする内容を選択します。 「エクスポートファイルをダウンロード」ボタンを押下するとXMLファイルがダウンロードされます。 % ls -l WordPress.2023-09-19.xml -rw-r--r-- 1 koba-masa staff 2152770 9 19 22:05 WordPress.2023-09-19.xml XMLのデータをMarkdownに変換する 次に、ダウンロードしたXMLファイルを解析して、Markdownとして出力をします。 If you want to move all of your existing post content to Astro, you may find this tool for exporting Markdown from WordPress helpful. You may need to make some adjustments to the result if you have to convert a large or complicated WordPress site to Markdown. 引用:https://docs.astro.build/en/guides/migrate-to-astro/from-wordpress/#switch-from-wordpress-to-astro 公式ドキュメントにlonekorean/wordpress-export-to-markdownという便利なツールが紹介されていましたので、こちらを利用して変換していきます。 上記のプロジェクトをgit cloneします。 % ls -l total 4600 -rw-r--r-- 1 koba-masa staff 198559 9 18 22:11 WordPress.2023-09-18.xml drwxr-xr-x 12 koba-masa staff 384 9 18 22:10 wordpress-export-to-markdown あとはREADMEに使い方が書いてありますので、それに倣って実行します。 % cd wordpress-export-to-markdown % npm install && node index.js Starting wizard... ? Path to WordPress export file? ../WordPress.2023-09-18.xml ? Path to output folder? ../. ? Create year folders? Yes ? Create month folders? Yes ? Create a folder for each post? Yes ? Prefix post folders/files with date? Yes ? Save images attached to posts? Yes ? Save images scraped from post body content? Yes ? Include custom post types and pages? Yes Parsing... 13 posts found. 0 attached images found. 49 images scraped from post body content. Saving 13 posts (0 already exist)... [OK] post - aws-踏み台サーバネットワークの構築 (省略) [OK] IMG_4709-scaled.jpg [OK] wyrd_member.jpg Done, got them all! All done! Look for your output files in: <your_directory> 指定したディレクトリにMarkdownファイルが出力されています。 % cd .. % ls -l total 4600 -rw-r--r-- 1 koba-masa staff 198559 9 18 22:11 WordPress.2023-09-18.xml drwxr-xr-x 3 koba-masa staff 96 9 26 22:29 posts drwxr-xr-x 12 koba-masa staff 384 9 18 22:10 wordpress-export-to-markdown % % find posts -type f post/2021/06/iosのショートカット機能を利用して勤怠管理を行-2/index.md (省略) post/2020/10/aws-踏み台サーバネットワークの構築/images/b8d665222d747a4d68fe084cfa02b58e.png post/2020/10/aws-踏み台サーバネットワークの構築/images/1989aa933c22cc3d909a3d5c949767a4.png post/2020/10/aws-踏み台サーバネットワークの構築/images/ed61dde1b9f396cf9d968414430bde58.png post/2020/10/aws-踏み台サーバネットワークの構築/images/6df701b87120fed4e4338211fc4ea7f7.png post/2020/10/aws-踏み台サーバネットワークの構築/index.md post/Invalid DateTime/Invalid DateTime/index.md % 完成 出力先のディレクトリの中身を丸ごと、src/pages/posts配下に移動し、サーバーを起動します。 % find src/pages/posts/2020 -type f src/pages/posts/2020/10/aws-踏み台サーバネットワークの構築/images/b8d665222d747a4d68fe084cfa02b58e.png (省略) src/pages/posts/2020/10/aws-踏み台サーバネットワークの構築/images/6df701b87120fed4e4338211fc4ea7f7.png src/pages/posts/2020/10/aws-踏み台サーバネットワークの構築/index.md 起動させた結果がこちらになります。 注意事項 実際には上記を実行しただけでは、起動しませんでした。 しかし、技術的に難しいことだったり、面倒なことではありません。 例えば、画像ファイルのパスがMarkdownファイルからの相対パスになってしまっていたので、適切なディレクトリに移動したり、チュートリアルで設定したプロジェクト独自の設定を反映させたりとエラーを読んで対処できるものばかりでした。 感想 移行作業そのものに関しては、良くも悪くもAstroだからという部分はありませんでした。 しかし、こんな簡単に移行できてしまうのかと驚きもしました。 今回は、Astroプロジェクト側にレイアウト等を整えたわけではないので、見栄えという点では微妙ですが、それこそAstroをうまく使いこなせば、良いものができると思います。 参考 AstroでCMSを利用する Migrating from WordPress
MySQLにおけるNOT NULL制約とDEFAULT制約
こんにちは、小林です。 今回は、MySQLのNOT NULL制約とDEFAULT制約について話をしたいと思います。 私はNOT NULL制約に関して、勘違いをして覚えてしまっており、レビュー時にそれを元に指摘をしてしまうことがあります。 それがついに3回目になってしまったので、ブログとしてまとめ、自分の中に定着させようと思い、筆を取りました。 勘違いしていたこと 「MySQLにおいて、NULLが格納されている既存のカラムに新しくNOT NULL制約を付与してもNOT NULL制約違反にはならない」という勘違いをしていました。 思考としては、以下のような感じです。 更新用のDML(INSERT、UPDATE、DELETE)を実行したときに制約は適用される 制約の追加(ALTER)はDDLのため、制約は適用されない ※但し、制約の追加後の最初の登録、更新時に該当カラムにNULL以外の値を入れないといけない 勘違いをしてしまっていた理由は、今回二つあることがわかりました。 制約が適用されるタイミングを誤認していた まず、制約の適用されるタイミングを誤認していました。 過去のプロジェクトで、DMLの実行時にトリガーを発火させるということをしていたことがあり、「トリガーはDMLの実行時に発火する」と覚えてしまっていました。 ※トリガーはDDL実行時にも発火させることが可能です。 そこから、いつの間にかトリガーと制約を取り違えてしまい、「制約がチェックされるのはDMLの実行時のみ」と思い込んでいました。 これにより、DDLの実行時には影響がないと勘違いをしていました。 MySQLとPostgreSQLにてNOT NULL制約の扱いが異なっていた こちらの方が本題で詳細は後述しますが、以下によって勘違いをしていました。 PostgreSQLでは、DEFAULT制約なしのNOT NULL制約を付与するとエラーとなる MySQLでは、DEFAULT制約なしのNOT NULL制約を付与してもエラーとならない ※条件によります MySQLではエラーにならないのだから、制約は動いていない 実際のところ、どうなのか? 検証 検証に使用したSQLはこちらのリポジトリに用意してあります。 koba-masa/play_with_sql 検証手順は、以下の通りです。 テーブルを作成する テーブルにレコードを登録する 新しいカラムを追加する カラムの追加と同時にNOT NULL制約を付与する・・・パターン1 カラムを追加後にNOT NULL制約を付与する・・・パターン2 MySQL パターン1 使用したSQLは、こちら。 mysql> SELECT * FROM not_null_when_add_columns1; +----+-----------+ | id | name | +----+-----------+ | 1 | nobunaga | | 2 | hideyoshi | +----+-----------+ 2 rows in set (0.00 sec) mysql> mysql> ALTER TABLE not_null_when_add_columns1 ADD COLUMN added_column VARCHAR(255) NOT NULL; Query OK, 0 rows affected (0.05 sec) Records: 0 Duplicates: 0 Warnings: 0 mysql> SELECT * FROM not_null_when_add_columns1; +----+-----------+--------------+ | id | name | added_column | +----+-----------+--------------+ | 1 | nobunaga | | | 2 | hideyoshi | | +----+-----------+--------------+ 2 rows in set (0.00 sec) mysql> カラムの追加に成功しました。※NUllが格納されている場合は、NULLと表示されます。 パターン2 使用したSQLは、こちら。 mysql> SELECT * FROM not_null_when_add_columns2; +----+-----------+ | id | name | +----+-----------+ | 1 | nobunaga | | 2 | hideyoshi | +----+-----------+ 2 rows in set (0.00 sec) mysql> ALTER TABLE not_null_when_add_columns2 ADD COLUMN added_column VARCHAR(255); Query OK, 0 rows affected (0.05 sec) Records: 0 Duplicates: 0 Warnings: 0 mysql> SELECT * FROM not_null_when_add_columns2; +----+-----------+--------------+ | id | name | added_column | +----+-----------+--------------+ | 1 | nobunaga | NULL | | 2 | hideyoshi | NULL | +----+-----------+--------------+ 2 rows in set (0.00 sec) mysql> ALTER TABLE not_null_when_add_columns2 MODIFY added_column VARCHAR(255) NOT NULL; ERROR 1138 (22004): Invalid use of NULL value mysql> カラムを追加した際に、カラムにNULLが設定されています。とエラーが出力されました。 PostgreSQL パターン1 使用したSQLは、こちら。 (結果一部抜粋) play_with_sql=# SELECT * FROM not_null_when_add_columns1; id | name ----+----------- 1 | nobunaga 2 | hideyoshi (2 rows) play_with_sql=# play_with_sql=# ALTER TABLE not_null_when_add_columns1 ADD COLUMN added_column VARCHAR(32) NOT NULL; ERROR: column "added_column" of relation "not_null_when_add_columns1" contains null values play_with_sql=# カラムを追加した際に、カラムにNULLが設定されています。とエラーが出力されました。 パターン2 使用したSQLは、こちら。 (結果一部抜粋) play_with_sql=# SELECT * FROM not_null_when_add_columns2; id | name ----+----------- 1 | nobunaga 2 | hideyoshi (2 rows) play_with_sql=# play_with_sql=# ALTER TABLE not_null_when_add_columns2 ADD COLUMN added_column VARCHAR(32); ALTER TABLE play_with_sql=# SELECT \* FROM not_null_when_add_columns2; id | name | added_column ----+-----------+-------------- 1 | nobunaga | (null) 2 | hideyoshi | (null) (2 rows) play_with_sql=# play_with_sql=# ALTER TABLE not_null_when_add_columns2 ALTER COLUMN added_column SET NOT NULL; ERROR: column "added_column" of relation "not_null_when_add_columns2" contains null values play_with_sql=# カラム追加時にはエラーになりませんでしたが、NOT NULL制約を付与した際にエラーが出力されました。 結論 MySQL NOT NULL制約のあるカラムを追加する際に、DEFAULT制約が設定されていない場合、(SQLモードによるが)その型のDEFAULT値が設定されるため、NOT NULL制約を回避する しかし、カラムを追加後にNOT NULL制約を追加する場合には先にNULLが設定され、そのカラムに対してNOT NULL制約を設定されることとなり、エラーとなる 明示的な DEFAULT 句のない NOT NULL カラムに対するデータエントリでは、INSERT または REPLACE ステートメントにカラムの値を含まれていない場合、または UPDATE ステートメントがカラムを NULL に設定する場合、MySQL はその時点で有効な SQL モードに従ってカラムを処理します。 参考:https://dev.mysql.com/doc/refman/8.0/ja/data-type-defaults.html PostgreSQL DEFAULT制約が指定されていないとNULLが設定されるため、エラーとなる 新しい列にはデフォルト値が初期値として入ります(DEFAULT句を指定しない場合はNULL値が入ります)。 参考:https://www.postgresql.jp/document/14/html/ddl-alter.html#DDL-ALTER-ADDING-A-COLUMN さいごに 毎回、調査して間違っていることに気づくのですが、しばらく経つと忘れてしまい、また指摘しまうという悪循環に陥っていました。 しかし、それもこれで終わりです。おそらく。。。きっと。。。多分。。。
自作した赤外線リモコンの全て - プログラムはChatGPTに書かせた!
最近、電子工作の新たなツールとして手に入れたテスター FNIRSI DSO-TC3の機能を試していたら、赤外線通信のデコード機能に感動しました。そして、思いついたのが自作の赤外線リモコンを作ること。なんと、そのプログラムは人工知能ChatGPTに書かせてしまいました! まずは、この驚きのプロジェクトの一部始終を以下の動画でご覧ください。 http://www.youtube.com/watch?v=xQ1xpEb7Fzg ただサーキュレータの電源をオンオフするだけのシンプルな動作ですが、確実に反応しています。プログラミング部分は実は私ではなく、AIのChatGPTが書いてくれたものなのです。ここではその驚きの過程を紹介します。 赤外線信号のデコード 初めにDSO-TC3を用いて赤外線信号のデコードを行いました。対象としたリモコンのボタンを押すと、以下のようなデコード結果が得られました。 UserCode: 0x80DE DataCode: 0x00FF この結果を基に、同様の赤外線信号を出力するリモコンを作るのが目標です。 電子部品の調達と回路作成 仕事の昼休みを利用して、赤外線LEDとRaspberry Pi Picoを購入しました。選んだのは光波長が940nmの赤外線LEDと、秋月電子オリジナルのRaspberry Pi Picoです。ブレッドボードと抵抗(22Ω)はすでに持っていました。 回路は赤外線LEDを使用しているものの、基本的には普通のLチカの配線と変わりません。 ChatGPTによるコード作成 さて、コードの作成ですが、これはChatGPTにお任せしました。ChatGPTとの対話を記録したスクリプトはこちらのChatGPTのスクリプトからご覧いただけます。 最初に生成されたコードは、さすがはChatGPT、それなりに完成度が高いものでした。しかし、実際にPicoに移して実行してみると、想定した値とは異なるデコード結果が出てしまいました。 UserCode: 0x017B DataCode: 0x00FF それで、この誤った結果を条件に加えてChatGPTに再度コードを生成してもらい、そして期待通りのデコード結果が得られました。以下に、そのコードを一部修正したものを載せておきます。 from machine import Pin, PWM import time def reverse_byte(b): b = ((b & 0xF0) >> 4) | ((b & 0x0F) << 4) b = ((b & 0xCC) >> 2) | ((b & 0x33) << 2) b = ((b & 0xAA) >> 1) | ((b & 0x55) << 1) return b def send_ir_code(pwm, code, bits): on = int((2**16-1) / 3) off = 0 # NECプロトコルに基づくIR信号送信 # Header pwm.duty_u16(on) time.sleep_us(9000) # 9ms pulse pwm.duty_u16(off) time.sleep_us(4500) # 4.5ms space # send for i in range(bits): pwm.duty_u16(on) time.sleep_us(560) # 560us pulse # 各ビットはoffの長さで決まる pwm.duty_u16(off) if code & (1 << (bits - 1 - i)): # 1 time.sleep_us(1690) else: # 0 time.sleep_us(560) # Stop bit pwm.duty_u16(on) time.sleep_us(560) # 560us pulse pwm.duty_u16(off) pwm = PWM(Pin(14)) pwm.freq(38000) # IR carrier frequency # カスタムコード 0x80DE, データコード 0x00FF custom_code = (reverse_byte(0x80) << 8) | reverse_byte(0xDE) data_code = reverse_byte(0x00FF) send_ir_code(pwm, (custom_code << 16) | data_code, 32) # 32ビットNECコード 主に使った機材と部品 RP2040マイコンボードキット 5mm赤外線LED 940nm OSI5LA5113A グレー (10個入) FNIRSI DSO-TC3 まとめ: AIによる電子工作 こうして見ると、計測機器とAIの力を組み合わせれば、赤外線通信の専門知識がなくても赤外線リモコンを自作することが可能です。初めての赤外線通信プロジェクトだったので、すんなりと作れるとは思っていませんでした。しかし、AIが生成したコードを読み解くことで、電子工作の知識も深まったと思います。これぞ、最新のDIY体験と言えるでしょう。
サービスやアプリケーション開発における中間層の設計と効果
イントロダクション ライブラリは、アプリケーションやサービスの開発において便利な道具です。しかし、ライブラリを直接使用することにはいくつかの課題や問題点が存在します。そこで、本記事では、ライブラリの使用におけるベストプラクティスとして、ラッパーや中間層の利点について探っていきます。 ライブラリの利用における課題 ライブラリの使用には、以下のような課題があります。 複雑さと柔軟性の問題 ライブラリは、多くの使用ケースを想定して開発されています。そのため、直接使用すると複雑なコードが必要になり、可読性や一貫性の維持が難しくなります。サービスやアプリケーションに特化したより具象的なAPIがあれば、開発効率や保守性が向上します。 ライブラリのバージョンアップの影響 ライブラリはバージョンアップが行われることがあります。しかし、バージョンアップに伴ってAPIが変更される場合、既存のサービスやアプリケーションに影響を与える可能性があります。ライブラリを直接使用する場合、バージョンアップによる修正作業や互換性の確保に時間とリソースが必要になることがあります。 抽象度と具象度のバランス ライブラリは一般化された抽象化されたツールですが、サービスやアプリケーションは具体的な要件やビジネスロジックに基づいて開発されます。ライブラリを直接使用すると、抽象度の高いコードと具象度の高いコードが混在することになり、開発や保守の複雑さが増します。 ラッパー・中間層の導入のメリット ラッパーや中間層を導入することで、ライブラリの利用における課題を解決し、以下のようなメリットを得るこことができます。 サービスやアプリケーションに特化したAPIの提供 ラッパーや中間層を介してライブラリを利用することで、より具象的でサービスに特化したAPIを提供することができます。これにより、開発者はライブラリの複雑さを隠蔽し、よりシンプルなインターフェースを利用することができます。 ライブラリの変更への影響の軽減 ラッパーや中間層を介してライブラリを使用すると、ライブラリ自体の変更がサービスやアプリケーションに与える影響を軽減することができます。ライブラリのバージョンアップや別のライブラリへの移行が必要な場合でも、ラッパーや中間層のみを修正すれば済むため、開発や保守の負荷が軽減されます。 抽象度と具象度のバランスの取れた設計 ラッパーや中間層は、抽象度と具象度のバランスを取りながら設計されます。ライブラリの抽象化された機能を具象化し、サービスやアプリケーションの具体的な要件やビジネスロジックに沿ったインターフェースを提供します。これにより、開発者はより具体的なコードを書くことができ、開発や保守が容易になります。 ライブラリの切り替えやバージョンアップの容易さ ラッパーや中間層を使用すると、ライブラリの切り替えやバージョンアップが容易になります。新しいライブラリが利用可能になった場合や既存のライブラリがメンテナンスされなくなった場合でも、ラッパーや中間層のみを修正すれば済みます。これにより、技術スタックの変更やアップグレードが柔軟に行えます。 まとめ ライブラリの直接使用には課題や問題が存在しますが、ラッパーや中間層を導入することでこれらの課題を解決できます。サービスやアプリケーションに特化したAPIの提供、ライブラリの変更への影響の軽減、抽象度と具象度のバランスの取れた設計、そしてライブラリの切り替えやバージョンアップの容易さを実現することができます。 ラッパーや中間層の導入により、開発効率や保守性が向上し、柔軟な開発プロセスを実現することができます。さらに、ライブラリのバージョンアップや別のライブラリへの移行が必要な場合でも、それらの変更への対応が容易になります。 ライブラリを使ったアプリケーションやサービスの開発において、ラッパーや中間層を導入して利点を最大限に活用しましょう。これにより、持続的な開発と変更への適応性を高め、高品質なソフトウェアを提供できるでしょう。 ラッパー・中間層の設計と実装 ライブラリの利用における課題を解決し、サービスやアプリケーションに特化したAPIを提供するためには、適切なラッパーや中間層を設計し、実装する必要があります。以下では、その設計と実装について詳しく説明します。 ラッパー・中間層の役割と目的の明確化 ラッパーや中間層を設計する前に、その役割と目的を明確化することが重要です。具体的には、以下のような点を考慮します。 ライブラリの機能を具象化し、サービスやアプリケーションに特化したインターフェースを提供すること ライブラリの変更への影響を最小限に抑えること テストやデバッグの容易性を確保すること ライブラリの機能を包括するAPIの設計 ラッパーや中間層の主な目的は、ライブラリの機能を包括するAPIを提供することです。このAPIは、サービスやアプリケーションの要件に合わせて具体化されるべきです。 APIの設計にあたっては、以下の点に留意してください。 シンプルさと直感的な使いやすさを重視すること サービスやアプリケーションの特定の機能やユースケースに焦点を当てること ドキュメントやコメントを充実させ、利用者にとって分かりやすい情報を提供すること テスト駆動開発(TDD)とラッパー・中間層のテスト ラッパーや中間層を設計・実装する際、テスト駆動開発(TDD)を活用することで品質保証を強化し、バージョンアップ時の互換性を確保することができます。 テスト駆動開発(TDD)を通じた品質保証 テスト駆動開発(TDD)は、ソフトウェアの品質を確保するためのアプローチです。この手法では、最初にテストケースを作成し、そのテストケースをパスするためのコードを実装していきます。 TDDをラッパーや中間層の開発に適用することで、次のようなメリットを享受することができます。 ラッパーや中間層の品質を保証し、予期せぬバグや問題の発生を防ぐ 変更時に既存のテストケースを実行し、互換性の問題を検出する 開発者がテストを実行することで、自信を持って変更を加えることができる ラッパー・中間層のバージョンアップ時のテスト ラッパーや中間層を使用する場合、ライブラリのバージョンアップに伴うテストも重要です。ライブラリのバージョンアップは、新機能の追加やバグ修正などの変更が含まれる可能性があります。 ラッパーや中間層のバージョンアップ時のテストには、以下のポイントに留意します。 ライブラリの新機能や修正が、ラッパーや中間層のAPIと互換性を持つかどうかを確認する 既存のテストケースが正常に動作するかを確認する ラッパーや中間層のテストケースを追加して、ライブラリの変更点をカバーする バージョンアップ時のテストは、ラッパーや中間層が期待通りに動作し、ライブラリの変更に対応できることを確認するために重要です。継続的な統合テストや自動化されたテストスイートを使用して、テストを自動化し、効率的に実行することも推奨されます。 ラッパーや中間層のテストを継続的に実施することで、ライブラリのバージョンアップ時に互換性の問題を早期に特定し、迅速な修正が可能となります。これにより、サービスやアプリケーションの安定性と信頼性を確保することができます。 まとめ ラッパーや中間層を設計・実装する際には、テスト駆動開発(TDD)を通じた品質保証とバージョンアップ時のテストが重要です。TDDにより、ラッパーや中間層の品質を確保し、変更時にも互換性を保つことができます。また、バージョンアップ時のテストは、ラッパーや中間層の正常な動作とライブラリとの互換性を確認するために必要です。 適切なテストケースを作成し、テストを継続的に実施することで、高品質なソフトウェアの開発と保守を実現しましょう。 実際の適用事例と効果 AWS S3の中間層の抽象化 AWS S3は一般的にはファイルを保存するストレージとして利用されます。しかし、そのストレージという概念をより抽象化することで、より柔軟な開発とテストが可能となります。ここでは、AWS S3の中間層の抽象化について紹介します。 通常、AWS S3の操作をテストする際には、ローカル開発環境や互換サーバー(LocalStackやMinioなど)を利用する必要があります。しかし、中間層を導入し、ストレージをキーバリューストア(KVS)のようなインターフェースとして扱うことで、ローカルでの開発やテストが容易になります。以下にFactory Methodパターンを用いた具体例を示します。 class KVS { put(key: string, value: any) { throw new Error("not implemented"); } get(key: string) { throw new Error("not implemented"); } } class S3 extends KVS { put(key: string, value: any) { s3client.put(key, value); } get(key: string) { return s3client.get(key); } } class Mem extends KVS { values: Record<string, any>; constructor() { values = {}; } put(key: string, value: any) { values[key] = value; } get(key: string) { return values[key]; } } この例では、KVSを基底クラスとして、S3クラスとMemクラスを実装しています。S3クラスはAWS S3を利用した実装であり、Memクラスはインメモリのキーバリューストアとしての実装です。 このような設計にすることで、以下のような効果が得られます。 開発効率の向上:インメモリの実装を利用することで、テストの実行時間が短縮されます。開発者は高速かつリアルタイムなフィードバックを得ながら、迅速に開発を進めることができます。 テストの容易化:中間層の抽象化により、ローカル環境でのテストが可能となります。これにより、依存関係のあるリモートサービスへのアクセスを避け、テストの安定性と信頼性を高めることができます。 バージョンアップへの柔軟な対応:中間層を通じてストレージの操作を抽象化することで、AWS S3のバージョンアップや他のストレージサービスへの移行が容易になります。既存の中間層の実装を修正することなく、異なるバックエンドサービスに切り替えることができます。 このように、AWS S3の中間層の抽象化によって、開発効率の向上、テスト容易性の向上、バージョンアップへの柔軟な対応が実現されます。中間層の設計と実装には慎重なプランニングとテスト戦略の確立が必要ですが、その努力は柔軟で信頼性の高いアプリケーション開発において大きな価値をもたらします。 以上が、AWS S3の中間層の抽象化に関する実際の適用事例と効果の紹介です。 その他の適用事例と効果 AWS S3の中間層の抽象化以外にも、さまざまな適用事例と効果が存在します。以下にいくつかの例を紹介します。 データベース中間層 データベースはアプリケーションにおける重要な要素ですが、直接データベースにアクセスすると変更が難しくなることがあります。そこで、データベース中間層を導入することで、データベースとの間に抽象化されたAPIを持つ中間層を作成します。これにより、データベースの変更や移行が容易になり、アプリケーションの柔軟性が向上します。 外部APIラッパー 外部のAPIとの連携を必要とする場合、APIラッパーを作成することで柔軟なコントロールとテスト容易性を実現できます。外部APIに依存せず、独自の抽象化されたインターフェースを提供することで、外部APIの変更による影響を最小限に抑え、アプリケーションの信頼性を高めることができます。 キャッシュ中間層 キャッシュはアプリケーションのパフォーマンス向上に重要な役割を果たしますが、直接キャッシュにアクセスするとテストが困難になることがあります。キャッシュ中間層を導入することで、キャッシュとのやり取りを抽象化し、テスト容易性と柔軟性を高めることができます。また、異なるキャッシュストレージ(メモリ、Redis、Memcachedなど)への切り替えも容易になります。 これらの適用事例によって、中間層の利用による柔軟性、保守性、テスト容易性が実現されます。各アプリケーションの要件やニーズに応じて、適切な中間層の設計と実装を行いましょう。 以上が、中間層の抽象化の実際の適用事例とそれによって得られる効果についての紹介です。 まとめ 中間層の設計と実装は、アプリケーションの柔軟性と保守性を向上させるために重要です。実際の適用事例から見ると、中間層は様々な場面で効果を発揮します。既存のライブラリを利用する際には、中間層を通じて抽象化することで、アプリケーションに特化したインターフェースを提供できます。これにより、開発効率の向上、テスト容易性の確保、バージョンアップへの柔軟な対応が可能となります。 中間層の設計と実装においては、適切なテスト戦略を構築し、テスト駆動開発(TDD)を通じた品質保証を行うことも重要です。テストを継続的に実施し、バージョンアップ時の互換性を確認することで、アプリケーションの信頼性を高めることができます。 中間層の導入は、柔軟性、保守性、テスト容易性を向上させ、アプリケーションの品質を確保するための有力な手法です。是非、これらの考え方と実践に基づいて中間層を活用し、高品質なアプリケーションの開発に取り組んでください。 持続的な改善と成長 中間層の設計と実装は、単なる一時的な解決策ではなく、サービスやアプリケーションの持続的な改善と成長にも寄与します。以下に、その重要性と効果について考えてみましょう。 アジャイルな開発と変更への柔軟性 中間層を持つアーキテクチャは、アジャイルな開発プロセスに適しています。中間層を介してライブラリや外部APIとの連携を行うことで、柔軟な変更への対応が可能となります。新しい要件やビジネス上の変更が発生した場合でも、中間層のインターフェースを修正するだけで済みます。これにより、開発者は迅速かつ効率的に変更を反映することができます。 システムの安定性と信頼性 中間層は、システムの安定性と信頼性の向上にも寄与します。中間層を介して行われる抽象化とエラーハンドリングにより、予期しないエラーや障害への対処が容易になります。また、中間層におけるテスト駆動開発(TDD)や品質保証によって、システムの品質を向上させることができます。 結論 中間層の設計と実装は、サービスやアプリケーションの品質や成長において重要な要素です。柔軟性とシステムの安定性を向上させるために、中間層を導入し、適切なテスト戦略を構築することをおすすめします。 ラッパーや中間層の使い分け 最後に、ラッパーや中間層の設計と実装において留意すべきポイントがあります。ラッパーや中間層は便利なツールではありますが、必ずしもすべての場面に適しているわけではありません。適材適所で使い分けることが重要です。 ライブラリを直接利用するべき場合もあります。既存のライブラリが提供する機能や性能が必要であり、ラッパーや中間層を介在させるメリットが少ない場合は、直接利用することが適切です。また、ラッパーや中間層を導入することで複雑性が増す場合や、開発効率に大きな影響がない場合も検討すべきです。 適切な判断をするためには、開発のニーズや要件をよく理解し、設計上のメリットとデメリットを検討することが重要です。また、実装後も適切なテスト戦略を持ち、品質保証を行うことが大切です。 結論 ラッパーや中間層は、サービスやアプリケーションの開発において便利な手法です。適切な設計と実装により、柔軟性、保守性、テスト容易性を向上させることができます。しかし、適材適所で使い分けることが重要であり、開発ニーズや要件に合わせて適切な判断を行う必要があります。 この記事を通じて、ラッパーや中間層の設計と実装の重要性、具体的な手法、適用事例、そして適切な使い分けについて理解していただけたことを願っています。